
Uma conversa pode começar em inglês, continuar em yorùbá e terminar em pidgin sem que os interlocutores considerem isso estranho. Em várias comunidades africanas, alternar entre línguas durante a mesma conversa faz parte da comunicação quotidiana. Para os sistemas de inteligência artificial, porém, compreender esse comportamento continua a ser um problema técnico relevante.
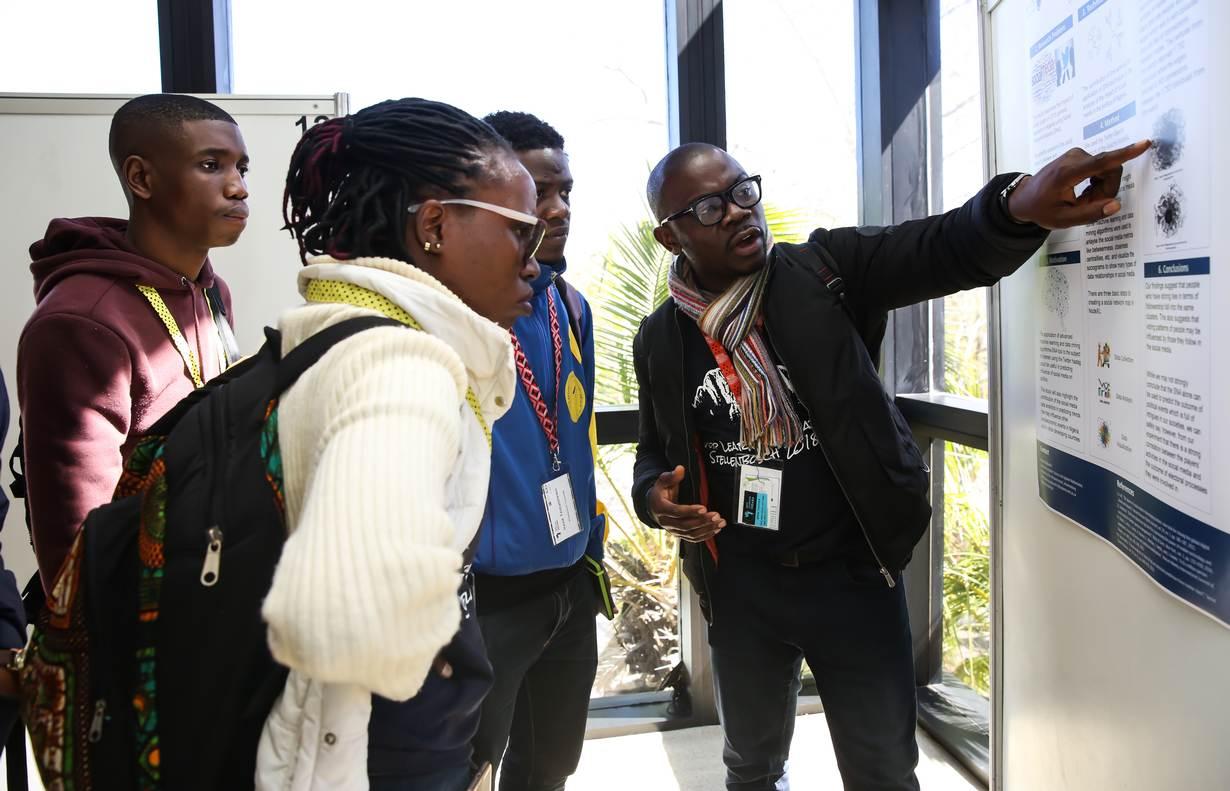
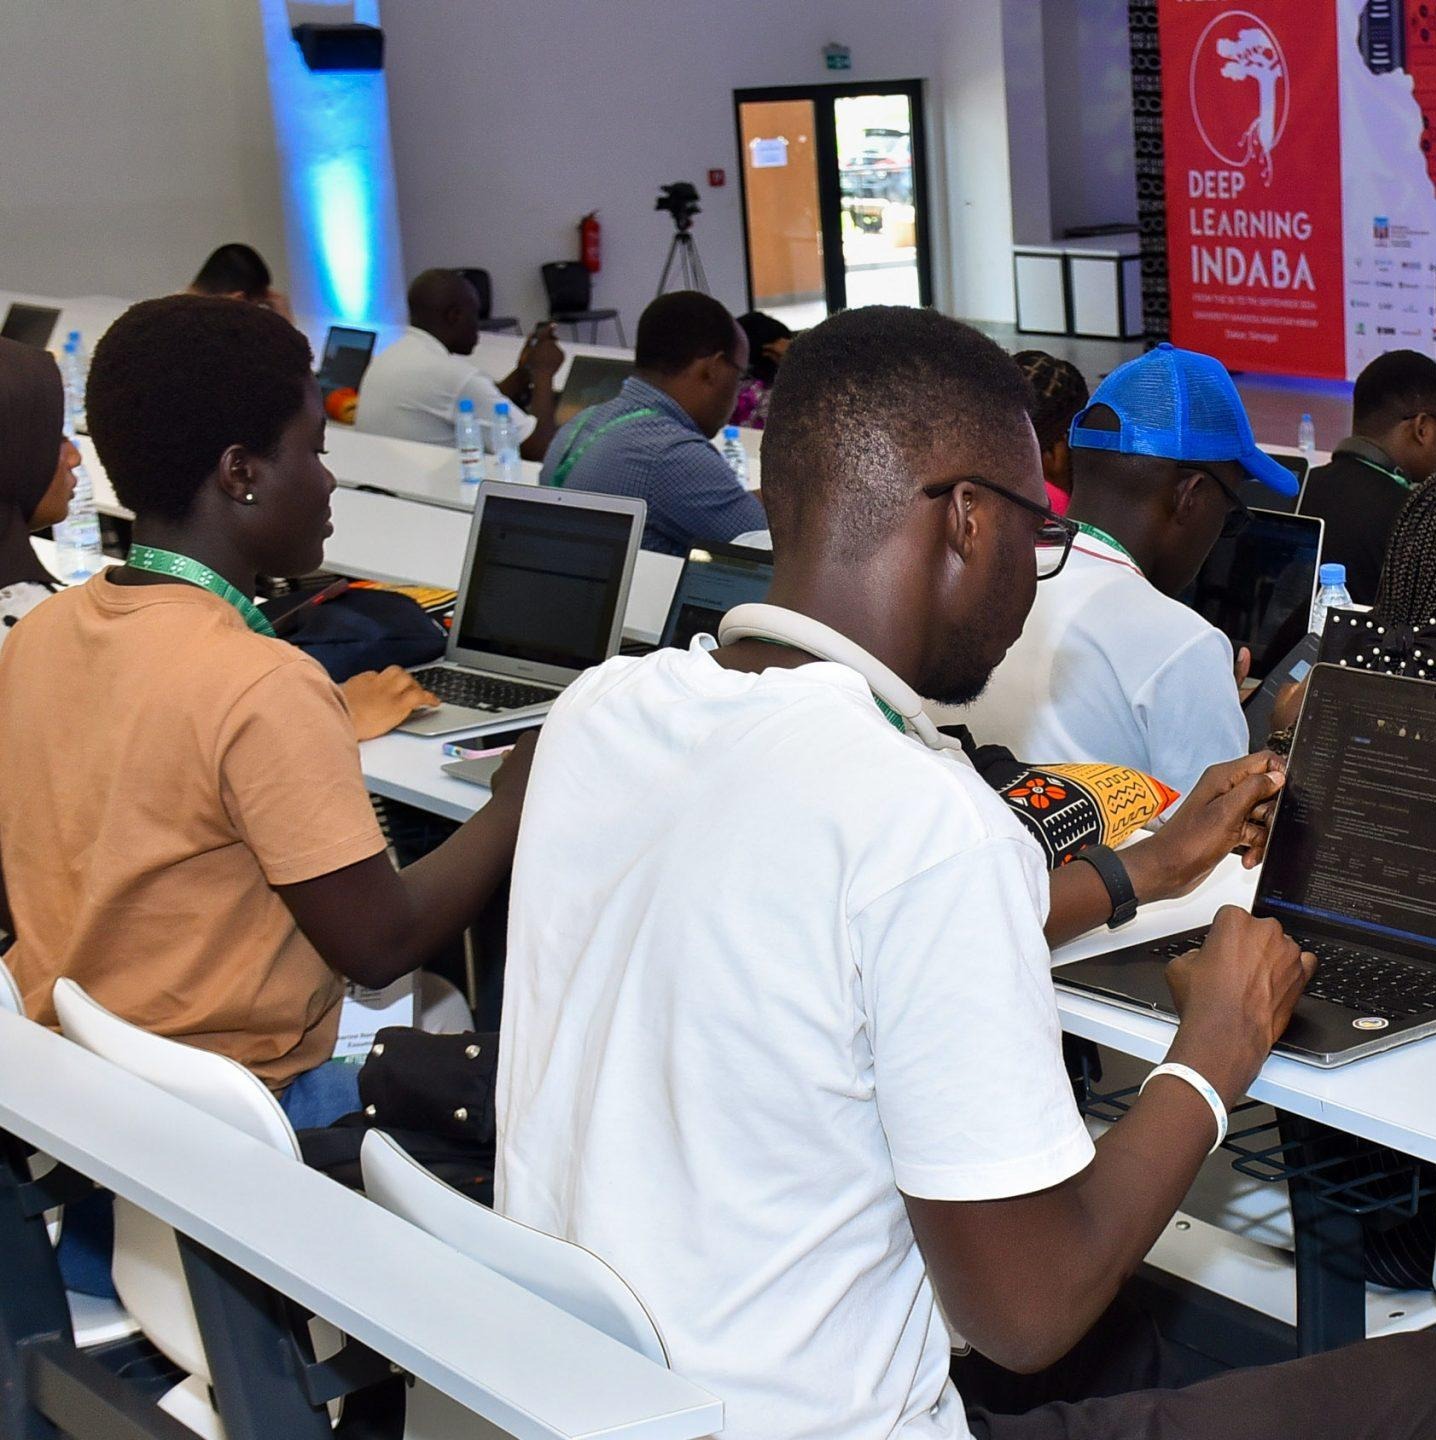
Foi precisamente esse desafio que mobilizou 97 equipas no Deep Learning Indaba 2026, realizado entre 2 e 7 de agosto na Pan-Atlantic University, em Lagos, Nigéria. Os participantes trabalharam no Sahara CodeSwitch Africa Challenge, uma iniciativa centrada no desenvolvimento de sistemas capazes de processar fala em que diferentes línguas aparecem na mesma conversa.
O desafio colocou uma questão particularmente africana no centro de uma das maiores comunidades de inteligência artificial do continente: como construir tecnologias de voz que compreendam a forma como as pessoas realmente falam?
Quando uma conversa tem várias línguas
Em inteligência artificial, o fenómeno é normalmente chamado de code-switching. Acontece quando uma pessoa alterna entre duas ou mais línguas dentro da mesma conversa ou até da mesma frase.
O problema é especialmente relevante em África devido à enorme diversidade linguística do continente e à utilização simultânea de línguas locais, nacionais e internacionais.
Um sistema de reconhecimento de voz treinado principalmente para identificar uma única língua pode funcionar razoavelmente bem enquanto a conversa permanece nesse idioma. Quando o utilizador muda naturalmente para outra língua, palavras podem ser interpretadas incorretamente, ignoradas ou transcritas como termos completamente diferentes.
Isso limita aplicações práticas como assistentes de voz, atendimento automatizado, transcrição de reuniões, legendagem, ferramentas educativas e interfaces controladas por voz.
Um desafio construído para África
Segundo a TechCabal, as 97 equipas participantes tiveram acesso antecipado a APIs de reconhecimento de fala orientadas para code-switching, além de conjuntos de dados africanos abertos. A competição incluiu ainda um prémio de 10 mil dólares.
O objetivo não era simplesmente criar mais um chatbot.
As equipas precisavam experimentar formas de construir aplicações capazes de trabalhar com fala multilíngue dentro de contextos africanos. Isso transforma uma limitação conhecida dos sistemas atuais numa oportunidade para programadores, investigadores e estudantes testarem soluções diretamente relacionadas com a realidade linguística do continente.
O contexto também é importante. O Deep Learning Indaba define-se como uma comunidade dedicada a fortalecer a investigação, a formação e a participação africana no desenvolvimento de inteligência artificial e machine learning. A edição de 2026 adotou como tema “Sovereign Intelligence: Africa’s Path in a Frontier AI World”.
Dados africanos tornam-se estratégicos
Para ensinar um sistema de IA a reconhecer diferentes formas de falar, são necessários dados que representem essas formas de comunicação.
É aqui que surge um dos maiores obstáculos para o desenvolvimento de tecnologias linguísticas africanas.
Grande parte dos sistemas comerciais de reconhecimento de voz possui enormes quantidades de exemplos para línguas como inglês. A disponibilidade de dados para muitas línguas africanas é consideravelmente menor, especialmente quando o objetivo é representar sotaques, contextos locais e combinações entre idiomas.
O próprio Deep Learning Indaba tem procurado estimular a criação e disponibilização de dados africanos. Na preparação da edição de 2026, a organização abriu uma chamada específica para submissão de conjuntos de dados relacionados com os desafios e oportunidades do continente.
Sem dados representativos, mesmo modelos tecnicamente avançados podem apresentar resultados fracos quando utilizados fora dos contextos em que foram treinados.
Comunidades podem resolver problemas ignorados pelo mercado
O envolvimento de 97 equipas demonstra também a importância das comunidades técnicas no desenvolvimento da inteligência artificial africana.
Problemas específicos de determinados mercados nem sempre recebem prioridade das maiores empresas tecnológicas internacionais. Para milhões de utilizadores africanos, porém, compreender corretamente uma conversa multilíngue pode determinar se uma aplicação de voz é realmente útil.
Hackathons, comunidades open source e encontros científicos permitem que investigadores e programadores trabalhem nesses problemas mesmo antes de existir um grande mercado comercial estabelecido.
O Deep Learning Indaba nasceu precisamente com essa lógica. A organização afirma que pretende fazer com que africanos não sejam apenas consumidores dos avanços da inteligência artificial, mas participantes ativos na construção e propriedade dessas tecnologias.
IA africana começa pelo contexto africano
O Sahara CodeSwitch Africa Challenge ilustra uma mudança importante na discussão sobre inteligência artificial no continente.
Construir IA para África não significa simplesmente disponibilizar modelos internacionais aos utilizadores africanos. Também significa identificar problemas locais, produzir dados adequados e criar sistemas capazes de compreender contextos que podem não estar representados nos produtos desenvolvidos noutros mercados.
Uma tecnologia de voz pode apresentar excelentes resultados num laboratório e, ainda assim, falhar numa conversa normal entre pessoas que alternam naturalmente entre diferentes idiomas.
Ao colocar 97 equipas a trabalhar sobre esse problema, o Deep Learning Indaba transforma uma característica quotidiana da comunicação africana num desafio concreto de engenharia.
E essa talvez seja uma das formas mais importantes de construir tecnologia relevante no continente: começar pela maneira como as pessoas realmente vivem, comunicam e utilizam a tecnologia.